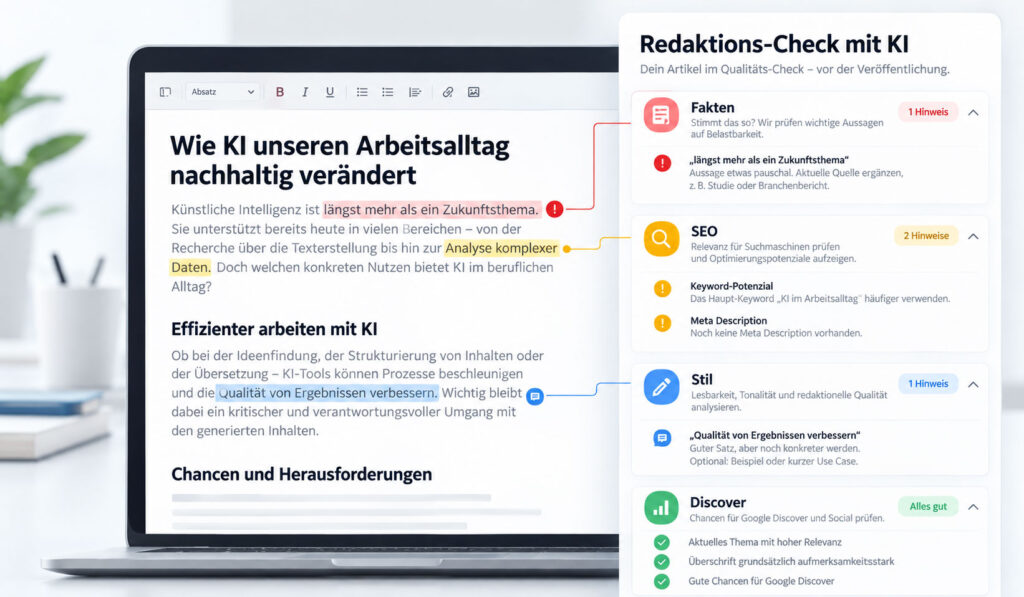
Inzwischen nutze ich ChatGPT immer öfter für etwas, das ich am Anfang nie auf dem Schirm hatte: Die KI soll nicht etwa Texte für mich schreiben, sondern meine fertigen Artikel einmal komplett auseinandernehmen.
Kurz vor dem Klick auf „Veröffentlichen“ bekommt sie den Beitrag vorgeschoben – zusammen mit einem ziemlich undankbaren Job: Finde die Schwachstellen. Suche nach widersprüchlichen Zahlen, übertriebenen Behauptungen, doppelten Gedankengängen, einer schlappen Überschrift oder Stellen, die schon aus drei Kilometern Entfernung nach KI-Floskeln riechen.
Klassische Rechtschreibfehler zu finden, ist dabei noch das Langweiligste.
Viel spannender ist für mich die Frage: Kann ein Sprachmodell als Sparringspartner im Redaktionsalltag taugen? Nach etlichen Durchläufen sage ich: Klar, absolut – allerdings nur, wenn man der KI punktgenau verklickert, wonach sie eigentlich suchen soll. Und vor allem: Wer ihr blind jedes Wort glaubt, ist selber schuld.
„Prüfe diesen Text“ ist die perfekte Formel für Frust
Mein erster Versuch war denkbar simpel. Ich habe der KI einen Artikel hingeworfen und meinte im Grunde nur:
Prüfe diesen Text auf Faktenfehler, Stil, SEO und Schwachstellen.
Das Ergebnis sah auf den ersten Blick beeindruckend aus: endlos lang, ordentlich gegliedert und vollgestopft mit Korrekturvorschlägen.
Dumm nur: Ein Großteil davon hat den Text verschlimmbessert.
Die KI fing an, absolut runde Sätze umzubauen, erfand ohne Grund neue Leserfragen und fand selbst an Stellen „Optimierungspotenzial“, die ich ganz bewusst kurz und knackig gehalten hatte.
Das Problem liegt am Auftrag selbst. Wenn du einer KI sagst, sie soll etwas „verbessern“, hört sie: „Finde Probleme!“ Und wenn sie keine echten findet, erfindet sie eben welche.
Heute gebe ich ihr deshalb klare Leitplanken mit:
Erfinde keine Fehler. Ändere funktionierende Stellen nicht aus Prinzip. Nenne mir nur die Dinge, die vor dem Veröffentlichen wirklich wehtun.
Das klingt banal, macht aber bei der Qualität der Rückmeldungen einen riesigen Unterschied.
Auch OpenAI rät inzwischen dazu, Prompts so konkret wie möglich aufzubauen und feste Ausgabeformate vorzugeben. Gleichzeitig geben die Entwickler offen zu: Sprachmodelle antworten nie zu 100 % deterministisch. Ein Prompt, der heute glänzt, kann morgen schon Aussetzer haben. Ohne ein paar Praxistests mit echten Texten geht es also nicht.
Nicht pauschal drübergehen, sondern gezielt nach Risiken fahnden
Anstatt die KI einfach mal „irgendwie“ drüberlesen zu lassen, knöpfe ich mir lieber einzelne Abschnitte und Risikozonen nacheinander vor. Dazu gehören bei mir:
- Stolpersteine bei Zahlen und Fakten
- Technische Plausibilität
- Unbelegte Superlative
- Übertreibungen und wilde Spekulationen
- Dopplungen im Textverlauf
- Holprige Formulierungen
- Haken bei Überschrift und Einstieg
- Suchintention und SEO-Passung
- Überschneidungen mit Beiträgen, die ich schon im Blog habe
- Und: Taugt das Thema für Google Discover?
Dieser Unterschied ist entscheidend. Die KI liefert meilenweit bessere Ergebnisse, wenn ich sie frage: „Sind Leistung und Energie in diesem Abschnitt sauber getrennt?“ statt pauschal: „Stimmt der Text fachlich?“
Das Gleiche gilt beim Schreibstil. Ich bitte sie nicht um „schönere Formulierungen“, sondern lasse sie gezielt nach Passiv-Monstern, Bandwurmsätzen, PR-Sprech oder typischem KI-Sprech suchen.
Mein Favorit: Die Jagd nach roten Flaggen
Den größten Mehrwert bringt mir schon lange nicht mehr die reine Textkorrektur, sondern der Blick auf rote Flaggen. Gerade bei technischen Themen lasse ich die KI gezielt nach typischen Denkfallen durchleuchten:
- Wird aus einem reinen Laborversuch plötzlich serienreife Technik gemacht?
- Verkauft der Text eine Simulation als echtes Messergebnis?
- Wird aus einem Prototyp ein fertiges Produkt gezaubert?
- Verwechselt der Text Maximalleistung mit Nenn- oder Dauerleistung?
- Werden Leistung und Energie durcheinandergewürfelt?
- Wird eine bloße Korrelation als Ursache hingestellt?
- Ist ein angeblicher Rekord überhaupt belegt?
- Und ganz wichtig: Stammt eine spektakuläre Aussage am Ende nur aus einer PR-Meldung?
Gerade der letzte Punkt passiert im Redaktionsalltag schneller als gedacht. Wenn ein Hersteller behauptet, sein neues Verfahren spare 40 % Energie, ist das erst mal nur eine Marketingaussage – und noch lange keine bewiesene Tatsache.
Die KI kann mich auf solche Stolperfallen hinweisen. Das ist extrem hilfreich. Ob die Behauptung am Ende stimmt oder nicht, kann sie mir allerdings nicht abnehmen.
Beim Faktencheck bleibt Misstrauen Pflicht
Hier liegt nämlich die größte Falle: Sprachmodelle verkaufen dir auch völligen Blödsinn mit einer Selbstbewusstheit, die beeindruckend ist.
Deshalb frage ich die KI gar nicht erst: „Welche Fakten im Text sind falsch?“
Sondern lieber so:
Welche Aussagen im Text würdest du vor dem Veröffentlichen noch einmal anhand einer Primärquelle überprüfen?
Das dreht die Rolle der KI komplett. Sie tut nicht so, als wäre sie die allwissende Faktencheckerin, sondern tippt mir als kritische Sparringspartnerin auf die Schulter. Ob das nun Zahlen, Kosten, Jahreszahlen, technische Kennwerte oder kühne Behauptungen sind – ich weiß sofort, wo ich lieber noch einmal nachfassen sollte.
Wenn das System Live-Zugriff aufs Netz hat, kann es im Anschluss sogar schon mal recherchieren. Aber auch dann passe ich auf: Eine Unternehmensmeldung hat schließlich ein völlig anderes Gewicht als ein wissenschaftliches Paper oder eine offizielle Behördenquelle.
Der Prompt hilft mir, die Recherche zu strukturieren. Das Nachdenken nimmt er mir nicht ab.
SEO prüfe ich heute komplett anders
SEO gehört bei mir zwar auch zum Schnellcheck – aber meilenweit entfernt von den alten Formeln nach dem Motto „Keyword in die H2, Keyword-Dichte bei 2,5 %“. Warum ich dieses klassische Keyword-Gezähle für Zeitverschwendung halte, habe ich bereits in meinem Beitrag „Warum klassische SEO-Texte langweilen“ ausführlicher beschrieben.
Mich interessieren beim Redaktionscheck ganz andere Fragen:
- Welche Suchintention steckt hinter dem Thema?
- Löst der Text das Versprechen auch wirklich ein?
- Fehlt eine wichtige Frage, die sich Leser beim Lesen garantiert stellen?
- Trägt die Überschrift den Inhalt?
- Bieten die Zwischenüberschriften echten Orientierungswert?
- Stehen da Absätze drin, die nur für die Suchmaschine getippt wurden?
Das deckt sich übrigens völlig mit dem, was Google seit Jahren predigt: Schreibt Inhalte für Menschen! Google achtet auf echte Praxiserfahrung, substanziellen Mehrwert, klare Quellen und ehrliche Überschriften.
Ein perfekter Score in irgendeinem SEO-Tool interessiert mich dagegen herzlich wenig. Ein Text kann laut Software eine Glanznote bekommen und trotzdem stinklangweilig zu lesen sein.
Und was ist mit Google Discover?
Auch Discover lasse ich die KI kurz abklopfen – allerdings mit einer gehörigen Portion Skepsis.
Wenn mir ein Tool sagt: „Dieser Artikel hat eine Discover-Chance von 87 %“, kann ich darüber nur schmunzeln. Dafür weiß schlicht niemand genau genug, warum Google manche Beiträge steilgehen lässt und andere links liegen lässt. Meine eigenen Erfahrungen dazu habe ich im Beitrag „Google Discover aus der Praxis: Warum sich Erfolg kaum planen lässt“ zusammengefasst.
Für den Schnelldurchlauf frage ich die KI deshalb viel bodenständiger: Hat das Thema überhaupt Zutaten, die es für Discover interessant machen könnten?
Sprich: Aktualität, Neuigkeitswert, ein Überraschungseffekt, starke Bilder und eine Headline, die den Kern auf den Punkt bringt. Das sind keine festen Rankingfaktoren, die man aufaddieren kann, sondern schlicht gutes redaktionelles Handwerk.
Google gibt zwar immer wieder neue Leitlinien heraus – etwa bei den Bildeinstellungen oder Sichtbarkeiten –, eine verlässliche Erfolgsgarantie gibt es aber nicht.
Deshalb teile ich das für mich lieber ganz pragmatisch ein in:
- geringes Potenzial
- mittleres Potenzial
- hohes Potenzial
Alles andere wäre reine Augenwischerei.
Eine gute Headline muss den Härtetest bestehen
Sehr gerne nutze ich die KI auch als Prüfstein für Überschriften. Gar nicht mal zwingend, um mir zehn neue Vorschläge ausspucken zu lassen. Sondern um meine eigene Headline gegen den Artikel zu testen:
- Hält die Überschrift, was sie verspricht?
- Ist der stärkste Fakt überhaupt drin?
- Trägt sie zu dick auf?
- Versteht man sofort, worum es geht – auch ohne Vorwissen?
- Zieht sie eher in der Suche oder auf Discover?
Das deckt sich mit einer alten Redaktionsweisheit, über die ich auch schon einmal geschrieben habe: Wer keine gute Überschrift findet, hat die Geschichte nicht verstanden. Die KI ist hier ein guter Sparringspartner. Die finale Entscheidung treffe aber immer noch ich.
Mein kompakter Check vor dem Veröffentlichen
Mein eigentlicher Prompt ist über die Zeit ziemlich lang geworden. Für den Alltag reicht aber meistens schon diese knackige Variante:
Mein Schnellcheck-Prompt:
Prüfe den folgenden Artikel kurz und streng vor der Veröffentlichung. Suche ausschließlich nach Problemen, die vor Veröffentlichung relevant sind.
Prüfe insbesondere:
- mögliche Faktenfehler
- widersprüchliche Zahlen
- technisch unplausible Aussagen
- unbelegte Superlative
- Übertreibungen und Spekulationen
- Aussagen aus PR-Meldungen, die als neutrale Fakten verkauft werden
- Dopplungen und Redundanzen
- Rechtschreib- und Grammatikfehler
- typische KI-Formulierungen und Sprachfloskeln
- Schwächen bei Überschrift und Einstieg
- fehlende Kerninformationen
- SEO-Passung und Suchintention
Erfinde keine Fehler und ändere funktionierende Passagen nicht aus Prinzip. Nenne maximal fünf kritische Punkte.
Beende die Analyse mit genau einer Einstufung:
- VERÖFFENTLICHEN
- VERÖFFENTLICHEN NACH KORREKTUR
- STOPP – ERST FAKTEN PRÜFEN
Der Prompt ist bewusst so gebaut, dass die KI den Text nicht gleich eigenmächtig umkrempelt. Ich will erst mal nur wissen, ob und wo es brennt. Der Rest ist meine Sache.
Wo die KI regelmäßig an ihre Grenzen stößt
So praktisch der Check im Alltag ist – man muss die Eigenheiten des Systems kennen:
- Die KI meckert gerne aus Prinzip: Wer ihr zehn Prüfpunkte hinwirft, bekommt fast garantiert zehn Kritikpunkte zurück. Deshalb ist der Befehl so wichtig, wirklich nur die relevanten Schwächen zu nennen.
- Die Ergebnisse schwanken: Derselbe Text kann bei zwei Durchläufen leicht unterschiedliche Kritik kassieren. Das liegt einfach in der Natur generativer Sprachmodelle. Wer Prompts professionell einsetzt, muss sie deshalb immer wieder an echten Beispielen testen.
- Ein plausibler Einwand ist noch lange kein echter Fehler: Das ist der tückischste Punkt. Wenn die KI behauptet, eine technische Zahl passe nicht, klingt ihre Begründung oft verdammt überzeugend. Am Ende hilft nur: Quelle selbst prüfen. Der Faktenchecker braucht eben manchmal selbst einen Faktencheck.
- Die KI kennt deine Absicht nicht: Manche unkonventionelle Formulierung ist völlig bewusst gewählt. Ein Einstieg ist vielleicht absichtlich knapp, oder eine Wiederholung dient bewusst der Klarheit. Welcher Gedanke dahintersteckt, weiß die KI nur, wenn du es ihr vorher sagst.
Es geht nicht darum, möglichst viele Fehler zu jagen
Genau das ist der Unterschied zu vielen typischen Optimierungstools da draußen: Ich brauche keinen Text, bei dem am Ende überall grüne Häkchen aufleuchten. Ich will einfach nur wissen, ob ich irgendwo etwas übersehen habe.
Das kann eine Zahl sein, die nicht ganz zur Quelle passt, eine unnötige Übertreibung, ein Gedanke, den ich doppelt gemoppelt habe, oder eine Headline, die mehr verspricht, als der Text hält.
Künftig werden KI-Agenten sicher noch viel mehr Redaktionsarbeiten übernehmen – von der tiefen Recherche bis zum Quellencheck. Was da auf uns zukommt, habe ich im Beitrag „Der Agent betritt die Redaktion: Was nach ChatGPT kommt“ ausführlicher beschrieben.
Ein einfacher Prüf-Prompt wirkt dagegen fast schon unspektakulär. Aber genau deshalb nutze ich ihn so gerne.
Ich lasse die KI nicht entscheiden, was online geht. Ich lasse sie mir vor der Veröffentlichung einfach noch einmal kurz widersprechen. Was ich aus diesem Widerspruch mache, bleibt am Ende immer noch echtes Handwerk.
Quellen
- OpenAI: Prompt Engineering – Hinweise zu klaren Anweisungen, strukturierten Prompts und Tests.
- OpenAI Help Center: Best Practices für Prompt Engineering in ChatGPT .
- Google Search Central: Hilfreiche, vertrauenswürdige und nutzerorientierte Inhalte erstellen .
- Google Search Central: Google Discover und Discover-Inhalte – Hinweise zu Sichtbarkeit, Bildern und geeigneten Inhalten.