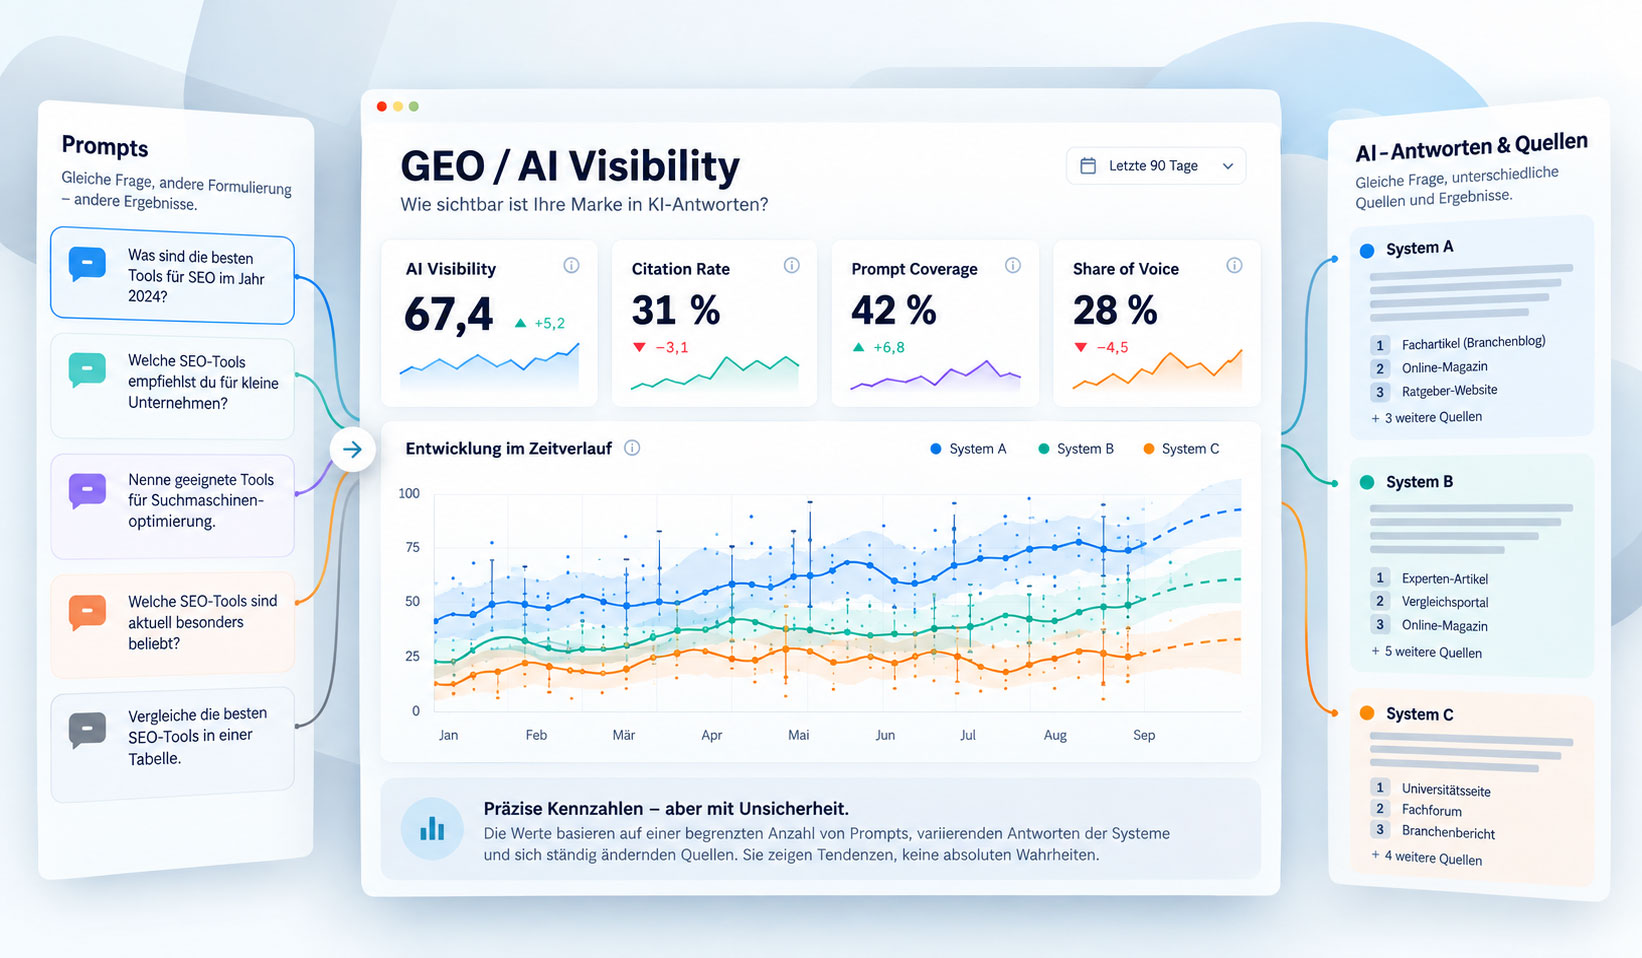
GEO hat inzwischen seine eigenen Kennzahlen. Tools zeigen, wie sichtbar eine Website in ChatGPT, Gemini, Perplexity oder Google AI Overviews ist. Sie vergleichen Marken miteinander, zählen Quellenangaben und berechnen daraus einen „AI Visibility Score“. Das wirkt erstaunlich präzise. Eine Website erreicht vielleicht 27 Prozent Sichtbarkeit, der wichtigste Konkurrent 34 Prozent. Nach einer Optimierung steigt der eigene Wert auf 31 Prozent. Also hat die Maßnahme funktioniert?
So einfach ist es nicht. Je länger ich mich mit Generative Engine Optimization beschäftige, desto mehr interessiert mich deshalb eine andere Frage als die nächste GEO-Maßnahme: Was können wir bei GEO überhaupt seriös messen?
Die Antwort fällt zweigeteilt aus. Ob eine Website in KI-Antworten auftaucht, lässt sich inzwischen ziemlich gut beobachten. Wesentlich schwieriger ist der Nachweis, warum sich ihre Sichtbarkeit verändert hat.
Was sich bei GEO tatsächlich messen lässt
Beginnen wir mit dem einfachen Teil. Ich kann einen Pool aus beispielsweise 500 Fragen zusammenstellen, die für meine Website relevant sind. Anschließend lasse ich diese Fragen regelmäßig von verschiedenen KI-Systemen beantworten und prüfe, ob meine Website als Quelle genannt wird, ob meine Marke auftaucht, welche URLs zitiert werden, bei welchen Themen ich besonders häufig sichtbar bin und welche Wettbewerber häufiger verwendet werden.
Daraus lassen sich sinnvolle Kennzahlen bilden. Die Citation Rate könnte beispielsweise angeben, bei welchem Anteil der untersuchten Fragen eine Domain als Quelle auftaucht. Die Mention Rate misst, wie häufig eine Marke genannt wird. Mit einem Share of Voice lässt sich vergleichen, welchen Anteil der Quellenangaben die eigene Website gegenüber Wettbewerbern erhält. Besonders interessant finde ich die Prompt Coverage: Bei wie vielen relevanten Themen oder Fragestellungen ist eine Website überhaupt vertreten?
Für einen Fachverlag könnte dadurch beispielsweise sichtbar werden, dass er bei Fragen zum Bauingenieurwesen regelmäßig als Quelle auftaucht, bei Energietechnik dagegen kaum. Damit kann ich arbeiten. Problematisch wird es erst, wenn aus solchen Beobachtungen eine scheinbar allgemeingültige Kennzahl wie „Ihre GEO-Sichtbarkeit beträgt 31 Prozent“ entsteht.
Wer die Prompts auswählt, bestimmt das Ergebnis mit
Denn schon vor der ersten Messung fällt eine wichtige Entscheidung: Welche Fragen werden überhaupt gestellt?
Nehmen wir eine Website, die viel über Wasserstofftechnik berichtet. Ein GEO-Tool könnte fragen: „Wie funktioniert ein PEM-Elektrolyseur?“ Ein anderes: „Welche Unternehmen stellen Elektrolyseure her?“ Ein drittes: „Welche deutschen Fachmedien berichten über Wasserstoff?“ Alle drei Tools messen anschließend angeblich die Sichtbarkeit zum Thema Wasserstoff. Tatsächlich untersuchen sie völlig unterschiedliche Informationsbedürfnisse.
Bevor ein GEO-Tool Sichtbarkeit misst, definiert es durch sein Promptset also bereits, was Sichtbarkeit überhaupt sein soll. Genau deshalb würde ich einem einzelnen AI-Visibility-Score niemals zu viel Bedeutung beimessen. Interessanter ist die Entwicklung eines sauber definierten und dauerhaft vergleichbaren Themen- und Promptsets.
Auch die Formulierung einer Frage spielt eine Rolle. „Welche Wärmepumpe ist für einen Altbau geeignet?“ kann andere Quellen hervorbringen als „Welche Wärmepumpen funktionieren bei hohen Vorlauftemperaturen?“ Wer GEO-Sichtbarkeit sinnvoll beobachten möchte, braucht deshalb nicht nur viele Prompts, sondern auch unterschiedliche Formulierungen derselben Suchabsicht.
Eine Messung allein reicht nicht
Hinzu kommt ein zweites Problem: KI-Antworten sind nicht vollständig reproduzierbar. Dasselbe System kann bei derselben Frage unterschiedliche Quellen verwenden. Modelle ändern sich, Suchsysteme werden angepasst und das Retrieval, also die Auswahl möglicher Informationsquellen, kann von einem Durchlauf zum nächsten variieren.
Ein umfangreicher Forschungsüberblick über 45 GEO-Studien beschreibt GEO deshalb nicht als einzelnes Ranking, sondern als mehrstufige und teilweise stochastische Pipeline. Dazu gehören unter anderem Suche, Retrieval, Auswahl der Quellen, Zitation und die tatsächliche Nutzung ihrer Informationen in der Antwort.
Für die Messung hat das eine ziemlich praktische Konsequenz: Ein Prompt sollte nicht einmal getestet werden, sondern mehrfach. Erst dann lässt sich erkennen, ob eine Domain regelmäßig erscheint oder bei einem einzelnen Testlauf zufällig dabei war.
Hier entsteht schnell Scheingenauigkeit. Eine Prozentzahl mit Nachkommastelle sieht exakt aus. Die zugrunde liegende Messung muss deshalb aber noch lange nicht genauso belastbar sein.
ChatGPT, Gemini und Perplexity sind keine einheitliche Messfläche
Noch komplizierter wird der Vergleich verschiedener Plattformen. ChatGPT, Gemini, Google AI Overviews und Perplexity funktionieren nicht identisch. Sie suchen unterschiedlich, wählen unterschiedlich viele Quellen aus und stellen diese Quellen unterschiedlich dar.
Eine Studie vom April 2026 untersuchte mehr als 600 kontrollierte Prompts und über 20.000 Quellenangaben. Dabei zeigte sich beispielsweise, dass Perplexity und Google im untersuchten Datensatz mehr Quellen zitierten. ChatGPT griff auf weniger Quellen zurück, die ausgewählten Quellen hatten dafür im Durchschnitt größeren Einfluss auf die generierte Antwort.
Damit ist auch klar: Eine Citation Rate von 20 Prozent bei ChatGPT lässt sich nicht ohne Weiteres mit 30 Prozent bei Perplexity vergleichen. Wer verschiedene Systeme beobachtet, sollte ihre Werte deshalb getrennt ausweisen.
Zitiert zu werden ist nicht dasselbe wie Einfluss zu haben
Ein weiterer Unterschied wird in vielen GEO-Auswertungen noch zu wenig beachtet. Eine Website kann als Quelle auftauchen, ohne die Antwort besonders stark zu prägen.
Die erwähnte Studie unterscheidet deshalb zwischen Citation Selection und Citation Absorption. Citation Selection bedeutet vereinfacht: Das KI-System hat eine Seite als Quelle ausgewählt. Citation Absorption geht einen Schritt weiter und fragt, wie stark Fakten, Argumente oder Strukturen dieser Quelle tatsächlich in die generierte Antwort eingeflossen sind.
Fünf Quellenangaben sagen deshalb wenig darüber aus, welche dieser fünf Quellen für die Antwort wirklich wichtig war.
Interessant ist außerdem, welche Inhalte in der Untersuchung besonders häufig einen hohen Einfluss hatten: unter anderem klar formulierte Definitionen, Zahlen, Vergleiche und nachvollziehbare Abläufe. Darin steckt allerdings weniger revolutionäre GEO-Technik, als es zunächst klingt. Gute Fachtexte sollten solche Informationen ohnehin klar vermitteln.
Beim Thema Chunking habe ich bereits ausführlicher beschrieben, warum verständliche und eigenständig funktionierende Informationseinheiten sowohl Menschen als auch KI-Systemen helfen. Daraus würde ich aber keine neue Schreibformel für KI-Systeme ableiten.
Die berühmten 40 Prozent beweisen weniger, als oft behauptet wird
Fast zwangsläufig stößt man bei GEO irgendwann auf eine Zahl: bis zu 40 Prozent mehr Sichtbarkeit. Sie stammt aus der Forschungsarbeit, mit der der Begriff Generative Engine Optimization bekannt wurde. Die Forschenden untersuchten verschiedene Veränderungen an Texten und konnten in ihrem Versuchsaufbau die Sichtbarkeit einzelner Inhalte teilweise deutlich verbessern.
Die Zahl ist also nicht erfunden. Man muss allerdings genau hinschauen, was damit bewiesen wurde. Die untersuchten Dokumente waren im experimentellen Informationskontext bereits vorhanden. Vereinfacht gesagt ging es darum, wie stark ein vorhandener Inhalt innerhalb einer generierten Antwort berücksichtigt wird.
Das ist etwas anderes als die Frage, ob ich durch eine Textänderung erreichen kann, dass ChatGPT, Gemini oder Perplexity meine Seite im offenen Web überhaupt häufiger finden und auswählen.
Der Forschungsüberblick von 2026 kommt hier zu einem ernüchternden Ergebnis. Für bereits abgerufene Inhalte lassen sich kausale Effekte auf Zitation und Nutzung nachweisen. Für einen stabilen, langfristigen und plattformübergreifenden Effekt einzelner Optimierungsmaßnahmen auf die organische Auffindbarkeit fehlt dagegen bislang belastbare Evidenz.
Gerade deshalb bin ich bei vermeintlichen GEO-Wundermitteln vorsichtig. Das gilt auch für Grounding Pages, deren Nutzen durchaus plausibel sein kann, ohne dass damit bereits ein messbarer Sichtbarkeitsgewinn bewiesen wäre.
Die eigentliche Frage lautet: Warum hat sich der Wert verändert?
Nehmen wir an, die AI Visibility einer Website steigt innerhalb von zwei Monaten von 18 auf 27 Prozent. Das ist zunächst eine Beobachtung. Die interessante Frage lautet: Warum ist der Wert gestiegen?
Vielleicht wurden 100 Artikel überarbeitet. Vielleicht sind gleichzeitig klassische Google-Rankings gestiegen. Vielleicht kamen neue Backlinks hinzu, vielleicht wurde die Marke häufiger in anderen Medien erwähnt oder die Website hat neue Inhalte veröffentlicht. Ebenso möglich ist, dass das KI-System sein Modell, seine Suche oder seine Quellenauswahl verändert hat.
Eine Veränderung nach einer GEO-Maßnahme beweist deshalb noch nicht, dass sie wegen dieser Maßnahme eingetreten ist.
Das Problem kenne ich aus einem anderen Bereich. Bei Google Discover lässt sich ebenfalls beobachten, dass bestimmte Artikel außergewöhnlich gut funktionieren, ohne dass sich aus einem einzelnen Erfolg automatisch eine allgemeine Regel ableiten lässt. Bei GEO gilt dasselbe: Beobachtungen sind wertvoll, solange man sie nicht vorschnell zu Kausalitäten erklärt.
So könnte ein seriöser GEO-Test aussehen
Wenn ich wirklich herausfinden möchte, ob eine Optimierung funktioniert, würde ich nicht einfach vorher und nachher einen Visibility Score vergleichen. Interessanter wäre ein Experiment.
Nehmen wir 100 ältere Artikel mit ähnlichen Voraussetzungen. 50 davon werden überarbeitet, etwa mit präziseren Definitionen, aktuelleren Zahlen, besseren Primärquellen, verständlicheren Zwischenüberschriften, klareren Tabellen und Vergleichen sowie eindeutigeren Angaben zu Autoren und Expertise. Die anderen 50 bleiben zunächst unverändert.
Vor der Änderung wird die KI-Sichtbarkeit beider Gruppen über ein festes Promptset mehrfach gemessen. Dasselbe geschieht anschließend über mehrere Wochen.
Entwickeln sich beide Gruppen ähnlich, spricht wenig dafür, dass die Änderungen den Unterschied gemacht haben. Steigt die Sichtbarkeit der überarbeiteten Beiträge dagegen deutlich stärker als die der Kontrollgruppe, wird das Ergebnis interessant.
Auch damit wäre die Kausalität noch nicht perfekt bewiesen. In einem offenen Web lassen sich nie alle Einflussfaktoren kontrollieren. Die Aussage wäre aber erheblich belastbarer als der typische Satz: „Wir haben 50 Artikel GEO-optimiert und unsere AI Visibility ist um 23 Prozent gestiegen.“
Solche kontrollierten Vergleiche würde ich gerne häufiger sehen.
Sichtbarkeit, statistischer Effekt und wirtschaftlicher Erfolg sind drei verschiedene Dinge
Ich würde GEO deshalb auf drei Ebenen messen. Erstens geht es um technische Sichtbarkeit: Wird meine Seite gefunden, genannt oder zitiert? Das ist vergleichsweise gut messbar.
Die zweite Ebene ist die statistische Veränderung. Taucht meine Website nach einer Maßnahme tatsächlich häufiger auf, und ist der Unterschied größer als die normalen Schwankungen? Dafür brauche ich genügend Prompts, wiederholte Messungen und Vergleichsdaten.
Die dritte Ebene ist die wirtschaftliche Wirkung. Führt die zusätzliche KI-Sichtbarkeit zu mehr Besuchern, Leads, Käufen, Abonnements oder anderen Geschäftszielen?
Dieser dritte Schritt ist besonders für Publisher wichtig. Denn eine Zitation allein bezahlt noch keine Redaktion.
Wie stark diese Trennung inzwischen wird, zeigt Google AI Overviews. Daten von Seer Interactive, über die Search Engine Land im April 2026 berichtete, zeigen zwar einen Vorteil für zitierte Seiten. Bei Suchanfragen mit AI Overview lag die organische Klickrate für zitierte Seiten in der Untersuchung bei rund 2,1 Prozent gegenüber etwa 0,9 Prozent für nicht zitierte Ergebnisse auf derselben Suchergebnisseite. Ohne AI Overview lag die Klickrate aber bei ungefähr 3,3 Prozent.
Zitiert zu werden ist demnach besser als nicht zitiert zu werden. Es ersetzt aber nicht automatisch den früheren Suchtraffic.
Gerade für Publisher ist diese Entwicklung Teil einer größeren Veränderung, die ich bereits im Beitrag über Publisher-SEO und die wachsende Bedeutung von KI-Systemen beschrieben habe.
Was ein GEO-Dashboard eigentlich zeigen müsste
Wenn mir heute jemand einen GEO-Report vorlegt, interessiert mich deshalb nicht zuerst der große Visibility Score. Ich möchte wissen, wie viele Prompts untersucht wurden, wie sie ausgewählt wurden, ob es verschiedene Formulierungen derselben Frage gab und wie oft jeder Prompt wiederholt wurde.
Ebenso wichtig ist, welche Plattformen untersucht wurden und ob ihre Ergebnisse getrennt ausgewiesen werden. Ich möchte sehen, wie stark die Resultate zwischen einzelnen Messungen schwanken und ob das Tool Erwähnungen, Quellenangaben oder tatsächlichen Einfluss auf die Antwort misst.
Und schließlich interessiert mich, was nach der GEO-Sichtbarkeit passiert ist. Gab es zusätzliche Klicks, Anfragen, Registrierungen oder Umsatz?
Ein Tool, das diese Fragen sauber beantwortet, liefert wertvolle Informationen. Ein Tool, das lediglich einen AI-Visibility-Wert von 67,4 ausgibt, erzeugt zunächst vor allem eine sehr präzise aussehende Zahl.
GEO ist relevant – gerade deshalb sollten die Maßstäbe höher werden
Ich halte GEO keineswegs für ein vorübergehendes Buzzword. Die Suche verändert sich. Nutzer erhalten immer häufiger fertige Antworten, bevor sie eine Website besuchen. Für Unternehmen, Publisher und andere Websitebetreiber wird deshalb wichtiger, ob ihre Inhalte überhaupt noch Teil dieser Antworten sind.
Diese Sichtbarkeit sollten wir messen. Nur sollten wir Beobachtung, Ursache und wirtschaftlichen Erfolg nicht miteinander verwechseln.
Wir können heute relativ gut feststellen, ob eine Website in KI-Antworten auftaucht und mit ausreichend vielen Messungen auch erkennen, ob sich diese Sichtbarkeit verändert. Wesentlich schwieriger ist die Aussage, warum sie sich verändert hat. Noch schwerer ist der Nachweis, welchen wirtschaftlichen Wert diese Veränderung besitzt.
Genau dort beginnt für mich die Grenze zwischen sinnvoller GEO-Analyse und Scheingenauigkeit. Ein Dashboard kann auf zwei Nachkommastellen ausrechnen, wie sichtbar eine Website angeblich in KI-Systemen ist. Die wichtigere Frage ist aber nicht, ob die zweite Nachkommastelle stimmt.
Die wichtigere Frage lautet: Messen wir überhaupt das Richtige?
Quellen
- Aggarwal et al.: GEO: Generative Engine Optimization – ursprüngliche GEO-Studie und GEO-Bench.
- Martinez, 2026: Optimizing Visibility in Generative Engines – Review von 45 GEO-Studien aus den Jahren 2023 bis 2026.
- Zhang, He & Yao, 2026: From Citation Selection to Citation Absorption – Untersuchung von Quellenwahl und tatsächlichem Einfluss auf KI-Antworten.
- Search Engine Land / Seer Interactive, 2026: Auswertung der Klickraten bei Google AI Overviews.